1. La tesis
Cuando le entregas trabajo a una máquina, lo único que le entregas son palabras. No puede ver tu oficina. No conoce a tus clientes. Tiene tus frases y los nombres de las cosas, y trata a ambos como verdaderos. Así que un nombre equivocado no es un pequeño desorden: es un hecho falso, metido en cada razonamiento que lo toca. No es información faltante: es desinformación. A algo llamado cimiento se le trata como cimiento, y la máquina construye encima. Todo lo que hay aquí se apoya en esta afirmación: el lenguaje es, por tanto, una pieza funcional del sistema, con sus propias pruebas y su propio mantenimiento, y no un adorno encima de él.
2. Léxico — qué palabras usamos
Todo equipo inventa un idioma privado sin darse cuenta. La misma palabra acaba significando dos cosas — en una sala un tipo de cliente, en la sala de al lado un paso de un proceso — y nadie se entera hasta que alguien usa, con el segundo significado, algo construido con el primero.
Aquí cada palabra importante tiene un significado escrito, y solo uno. Es un renglón en una base de datos, no una nota en un documento. Dice qué significa la palabra, qué no significa, quién lo decidió y cuándo. Usa una palabra en contra de su significado y las herramientas detienen el trabajo antes de guardarlo.
Una palabra también se puede retirar. Cuando resulta equivocada, no se borra en silencio: se retira con una sucesora, para que el registro diga qué escribir en su lugar, y quien lea la palabra vieja más adelante se entere de qué le pasó.
3. Taxonomía — cómo se ordenan las palabras
Por encima del inventario de palabras está la pregunta de qué clase de palabra es cada una: nombre de una cosa, nombre de un hacer, nombre de una regla, nombre de una relación entre dos cosas. Ordenarlas no es archivar por archivar. Es lo que permite a un programa preguntar si una frase siquiera está bien formada, antes de que alguien discuta si es verdadera.
4. Ontología — qué clases de cosas existen, y cómo se relacionan
Luego la pregunta más vieja y más difícil: ¿qué clases de cosas hay, en realidad? Una persona es una clase de cosa. También lo son un acuerdo, un lugar, una suma de dinero, un encuentro entre dos personas. Ninguna de esas es la misma clase de entrada que una capacidad como buscar, o llevar un registro que no se puede alterar — y fingir lo contrario es como un sistema acaba con una tabla que significa cuatro cosas. Qué clase de cosa es algo se decide antes que cómo construirlo.
5. Gramática — qué combinaciones se permiten
Saber las palabras y sus clases todavía no te dice qué frases son legales. Eso lo dice una gramática. Unas cosas pueden apoyarse en otras y otras no. Una regla puede restringir un proceso; un proceso puede cambiar un estado; un producto es una disposición permitida de piezas, no un montón cualquiera de ellas. Aquí es donde la arquitectura deja de ser un diagrama que alguien dibujó y se vuelve un conjunto de combinaciones que un programa puede aceptar o rechazar.
6. Una persona resuelve; una máquina solo puede proponer
Una máquina puede notar que se están usando dos palabras para una sola cosa. Puede proponer una mejor y exponer el argumento. Puede señalar cada lugar donde aparece la vieja.
Lo que no puede es decidir. Y no es una regla de la casa que alguien pueda olvidar: la propia base de datos rechaza una resolución que venga de una máquina. El significado lo fija una persona, y esa decisión queda escrita con fecha y con un nombre. 252 palabras se han fijado así hasta ahora.
7. Observación, atribución, presunción
Tres cosas distintas se mezclan constantemente en la escritura común, y mantenerlas separadas resulta importar enormemente.
- Lo que se observó. El disco no giró. Falta la columna. La prueba salió roja. Cualquiera puede comprobarlo.
- Lo que se atribuye. El juicio de alguien sobre qué significa — de quién es ese juicio forma parte de la afirmación, y se registra junto con ella.
- Lo que se presume. El hueco entre las dos, rellenado en silencio. Esta es la que causa los problemas, porque se lee exactamente igual que la primera.
Así que un dato ausente se anota como ausente. Una lectura que no se pudo tomar dice que no se pudo tomar. Una pieza que nunca se revisó dice sin revisar, no «bien». A una máquina que no alcanza a ver un número de serie se le obliga a decir de qué modo falló — desenfocado, al revés, tapado — de una lista corta de modos, para que una persona sepa qué hacer al respecto.
8. Sustantivo, verbo, dato — el trabajo escrito como partes de la oración
El trabajo mismo se escribe en una forma pequeña y deliberadamente aburrida, tomada de la gramática. Una cosa, algo que se le hace, y lo que sale: sustantivo, verbo, dato. Tomás abre la hoja de cálculo. La hoja de cálculo da renglones de clientes. Los renglones entran en una carta. Cada uno de esos es un eslabón, y el dato de un eslabón es el sustantivo del siguiente, que es lo que lo convierte en cadena y no en montón. El sustantivo es una palabra gobernada, no cualquier palabra — y el verbo también. El dato es la cosa concreta y comprobable, un renglón o un archivo o un número, que es como un programa puede saber si de verdad existe.
9. Meta — la parte que todo el mundo olvida
Una cadena puede estar perfectamente bien formada y aun así no servir de nada, así que hay una cuarta parte que pertenece a la cadena entera y no a ningún eslabón: la meta. Por qué se hace, dicho antes de empezar, de una forma que alguien pueda comprobar después. Una secuencia que produce un archivo pero no sabe decir para qué era ese archivo no puede cerrarse. Y la meta nunca la califica la misma corrida que hizo el trabajo: un trabajo no se pone su propia nota.
10. Fragmentación semántica — mostrar la forma, no el contenido
Si lo que recibe una máquina son palabras, entonces la pregunta de cuáles palabras es tanto de privacidad como de exactitud. Un documento se descompone primero en tu propia computadora, en su forma: cuántas partes, de qué clase, quién habló cuándo, qué campos están vacíos — con los nombres y el contenido sustituidos por marcas. Esa forma suele bastar para responder la pregunta. La declaración nunca sale del edificio; una descripción de su estructura sí. Y qué máquina puede ver siquiera eso depende de qué material sea. Cada vez que algo cruza la línea, queda registro de exactamente qué cruzó.
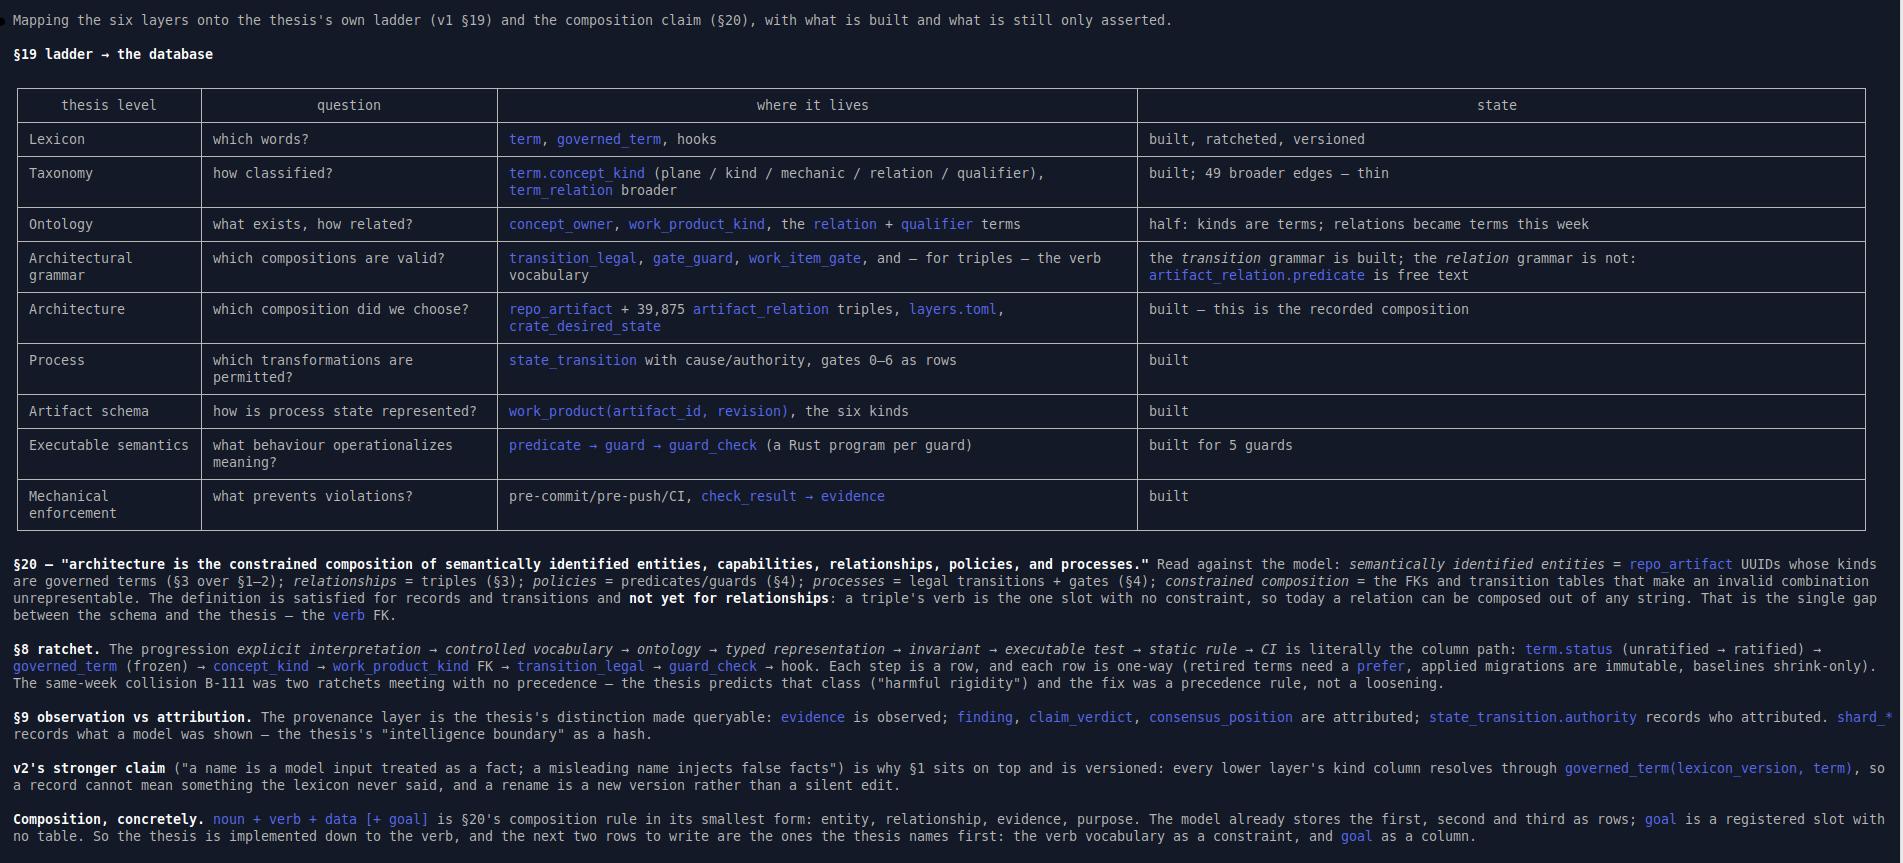
11. Medido, no creído
Nada de esto valdría mucho si fuera solo una creencia sobre cómo leen las máquinas. Así que se puso a prueba. A varios modelos se les mostró únicamente los nombres de las cosas y se les preguntó dónde encajaba cada una.
El mejor de ellos acertó el 59%. El más listo lo hizo peor, con un 39% — y los dos cometieron el mismo error: leer un nombre como una afirmación sobre importancia que el nombre nunca pretendió hacer. Con nombres que decían la verdad, los dos acertaron siempre.
Ese resultado es la razón de que esto sea ingeniería y no gusto personal. La medición está publicada, junto con las corridas que salieron mal.
De dónde viene esto
Durante treinta años después de graduarme de Washington University, la licenciatura en letras inglesas fue lo que salía en las fiestas y en ningún otro lado. Luego llegaron máquinas que toman el lenguaje como entrada, y resultó que la formación útil era la que pregunta a qué se refiere realmente una palabra, si dos personas que la usan quieren decir lo mismo, y qué le pasa a una discusión cuando no.
Aquí eso no es una metáfora. El vocabulario es una tabla que puedes consultar. Dos palabras para una cosa es una falla que reporta un programa. La versión larga es la tesis.